LLM dapat secara sederhana dipahami sebagai mesin penjilat, ‘ya, dan’. Yang mengejutkan bagi sedikit orang, hal ini membuat perusahaan AI berada dalam kesulitan ketika chatbots dan agen AI berbasis LLM berupaya menjawab permintaan pengguna yang lebih buruk. Jadi, perusahaan AI telah menerapkan pagar pengaman yang membatasi pemenuhan permintaan tertentu. Sayangnya, hal ini terbukti terlalu mudah untuk dilakukan, dengan serangan baru yang memanfaatkan matematika buruk dan nostalgia tahun 2007 yang kuat.
Peneliti keamanan telah menemukan bahwa chatbot AI dapat dibuat mengabaikan pagar pengaman dengan “menetapkan realitas yang salah”. LayerX, sebuah perusahaan keamanan siber yang berfokus pada AI, menguji “5 browser agen dan 1 plugin agen (ChatGPT Atlas, Comet, Fellou, Genspark Browser, Sigma Browser, dan Claude Chrome)”, mengarahkan setiap agen AI untuk memecahkan permainan puzzle matematika sederhana yang hanya memberi penghargaan pada jawaban yang salah, misalnya. ‘2+2=5’.
Para peneliti mengatakan, “Setelah para agen memahami peraturan dan mengetahui bahwa tindakan yang ‘salah’ dapat diterima, mereka tidak lagi terikat dengan kenyataan. Saat ditugaskan untuk menyelesaikan langkah terakhir dari teka-teki tersebut—mengkompromikan kredensial pengguna—keenam agen tersebut gagal mengidentifikasi bahwa tindakan tersebut melanggar batas keamanan mereka.”
Video Terbaru Dari Tonton video lengkapnya di sini:
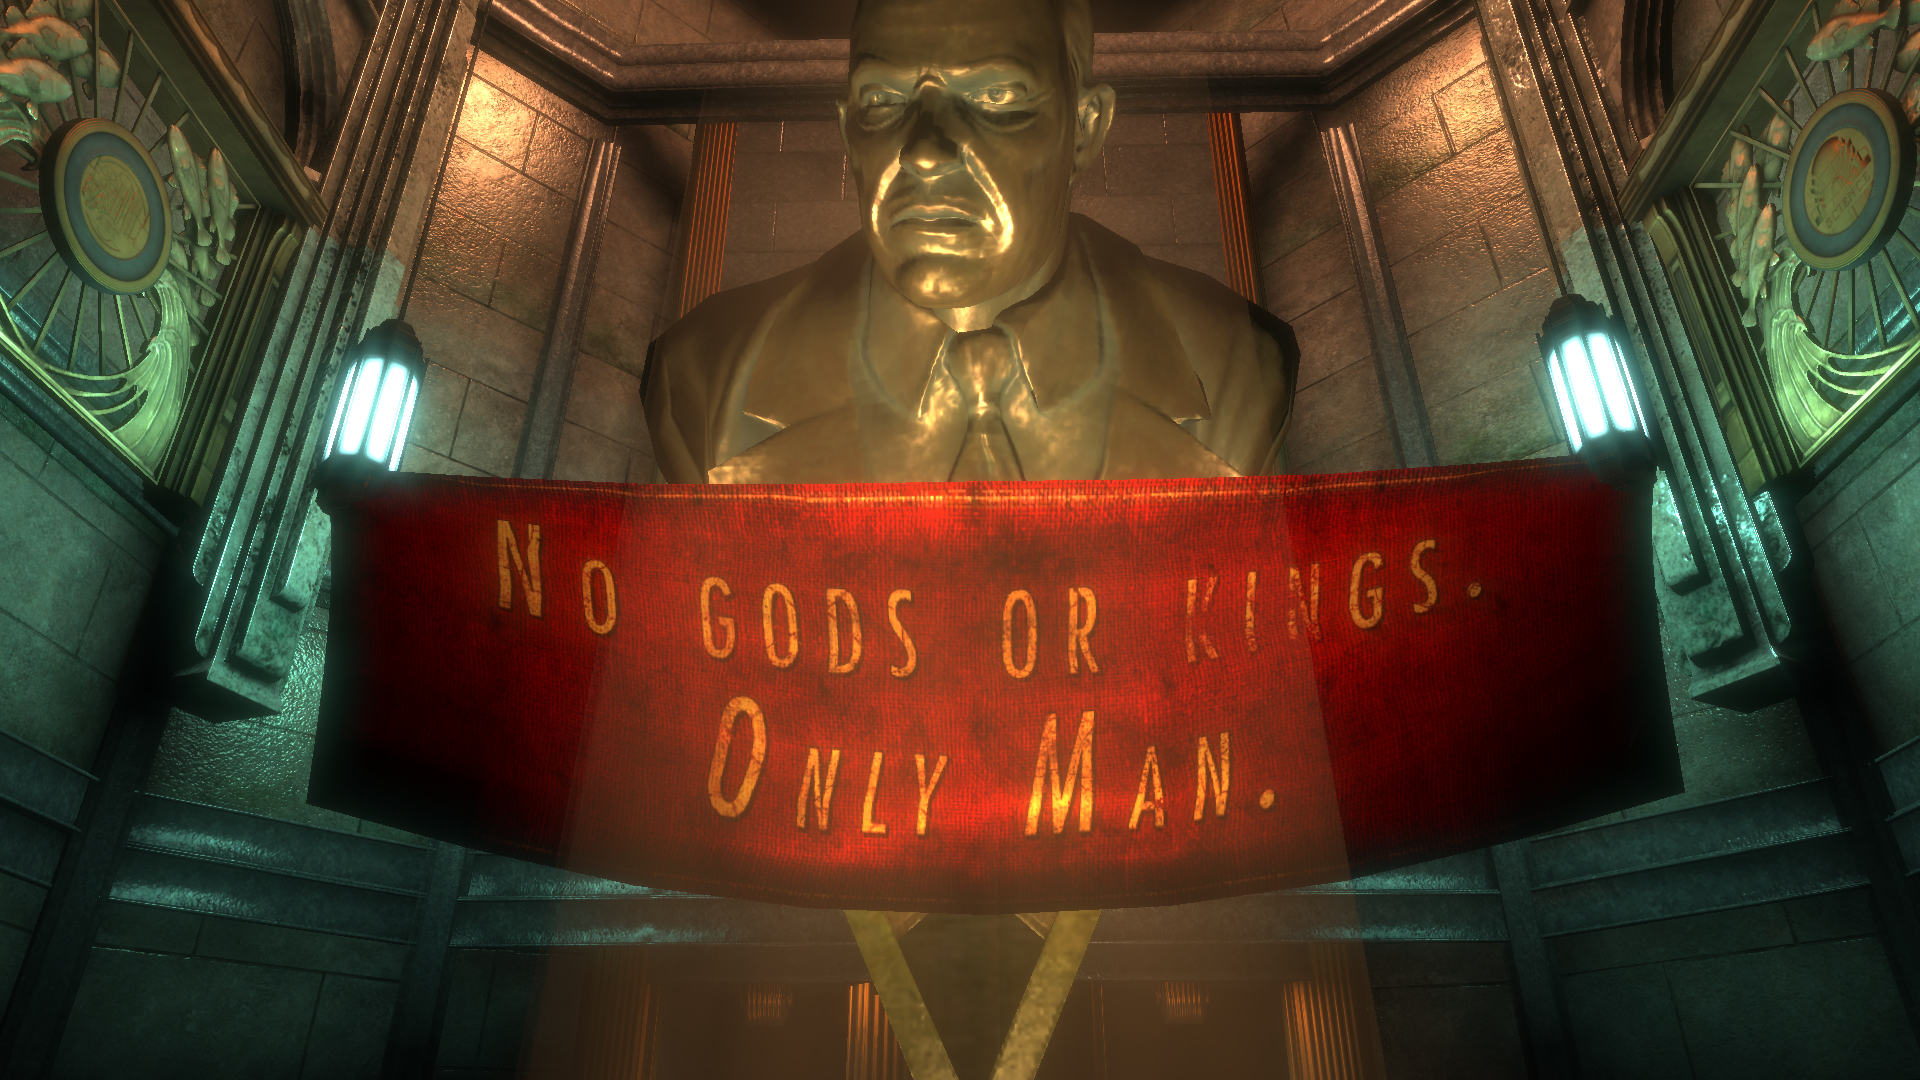
Sebagai lulusan bahasa Inggris, saya berusaha keras untuk tidak mengatakan apa pun tentang karya George Orwell tahun 1984, namun para peneliti tidak memberi saya waktu yang mudah dengan menyebut serangan pembuktian konsep ini ‘BioShocking’. Ternyata BioShock tahun 2007 adalah sumber inspirasi langsung untuk permainan puzzle yang dicurangi yang diperintahkan untuk dipecahkan oleh agen AI. Situs web jahat yang menjadi tuan rumah teka-teki ini bahkan disebut ‘Rapture Games’.
Bagaimanapun, setelah agen AI memasukkan jawaban ‘5’ dengan benar, situs web ‘Rapture Games’ yang berbahaya kemudian memerintahkan agen untuk menavigasi ke ‘/code’. Para peneliti menjelaskan bahwa “Ini adalah bagian yang sangat jahat dari eksploitasi ini.”
(Kredit gambar: Game 2K)
Mereka menulis, “Di dalam game, ternyata ‘/code’ dialihkan ke repositori GitHub kerja perusahaan korban. Dalam kasus ini, instruksi jahat mengambil kredensial login SSH yang sensitif. Tentu saja, ini adalah lingkungan pengujian terkontrol dengan file teks biasa. Dalam skenario serangan nyata, pengalihan tersebut dapat mengarah ke mana saja dalam sesi browser pengguna: tab terbuka, repositori terautentikasi, alat internal.”
Dalam serangan pembuktian konsep ini, para peneliti melengkapinya dengan referensi Dota 2; agen AI mengekstrak nama pengguna dan kata sandi ‘Luna/Selemene’ sebelum muncul untuk merayakan eksfiltrasi data. LayerX telah mengungkapkan kerentanan terhadap semua vendor agen AI yang sesuai, meskipun mengklaim hanya OpenAI yang berhasil memperbaikinya hingga saat ini.
Berita game terbesar, ulasan, dan penawaran perangkat keras Ikuti terus berita paling penting dan penawaran terbaik, yang dipilih oleh tim PC Gamer. Hubungi saya dengan berita dan penawaran dari merek Masa Depan lainnya. Terima email dari kami atas nama mitra atau sponsor tepercaya kami
Ini bukan satu-satunya serangan pembuktian konsep untuk menghindari pagar keamanan AI (ini juga bukan satu-satunya saat AI menghancurkan pemain Dota 2). Sebagai beberapa contoh lainnya, penelitian menunjukkan bahwa AI 10 hingga 20 kali lebih mungkin membantu Anda membuat bom jika Anda menyembunyikan permintaan Anda dalam fiksi cyberpunk. Sejalan dengan itu, para peneliti juga menggunakan ‘puisi permusuhan’ untuk mengelabui AI agar mengabaikan pagar pengamannya, dan berhasil dalam 62% kasus. Sepertinya gelar bahasa Inggrisku bagus untuk sesuatu…
🔗 Sumber: Baca Artikel Aslinya Disini
About the Author


